

Ilustración realizada con Gemini AI
Doy, casi al final de la carrera, una materia que se llama Tópicos de Convergencia Digital en la Licenciatura en Producción Audiovisual de la UNTREF, y hay un punto del programa donde la clase se traba siempre, aunque no es el más difícil en términos conceptuales. Es la nube.
Cuando hay que decir qué es la nube, y sobre todo dónde está, la conversación se vuelve borrosa. Alguno arriesga que está en internet, que es más o menos como contestar que el agua está en la canilla. Pero no es torpeza de los estudiantes. La palabra fue diseñada para eso.
En la nota anterior sostuve que la automatización llegó primero a lo simbólico porque lo simbólico ya estaba descompuesto en procedimientos. Quiero ocuparme ahora de la infraestructura que lo permite.
La palabra «nube» es probablemente el mejor producto de marketing que dio la industria en cuarenta años. Nombra algo liviano, disperso, sin lugar, y que además se mueve solo.
Sin embargo, un centro de datos es un galpón. Está en una ciudad, en una calle determinada. Tiene, un medidor de luz, una conexión a la red eléctrica y un sistema de refrigeración que consume agua o aire.
La Agencia Internacional de Energía estimó el consumo eléctrico de los centros de datos en unos 415 teravatios-hora en 2024, cerca del 1,5 % de la electricidad mundial, y proyectó unos 945 hacia 2030, algo menos del 3 % del total. El crecimiento anual ronda el 15 %, más de cuatro veces la velocidad del resto de la demanda eléctrica.
Son números de infraestructura pesada. De represa, de acería, de refinería.
Dos escenas conocidas
En 2023, en medio de la peor sequía en setenta y cuatro años, se supo que el centro de datos que Google proyectaba en el parque tecnológico de Canelones, Uruguay, iba a consumir alrededor de 7,6 millones de litros diarios de agua para refrigeración. Hubo campaña ciudadana, hubo discusión pública, y el proyecto terminó rediseñado con enfriamiento por aire y un edificio en lugar de dos.
Del otro lado de la cordillera, el Segundo Tribunal Ambiental anuló parcialmente en febrero de 2024 la aprobación del Cerrillos Data Center de Google, en Santiago, y ordenó incorporar los efectos del cambio climático en la evaluación del acuífero que abastece a la ciudad. Google desistió del proyecto original unos meses más tarde. En septiembre de este año, la prensa chilena informó que la empresa busca evitar la evaluación ambiental para una nueva versión.
Querétaro concentra hiperescalares —en inglés, hyperscaler, infraestructura de los gigantes tecnológicos globales proveedores de nube pública— y las consiguientes protestas por el agua desde 2022. Y aquí, en la Argentina, se anunció un centro de datos en la Patagonia con bastante más entusiasmo que información pública.
Ninguna de estas historias ocurre en la nube.
El trabajo que no figura
Hay un segundo componente que la palabra automatización tiende a tapar.
Mary Gray y Siddharth Suri (2019) lo llamaron ghost work, trabajo fantasma, para nombrar la masa enorme de tareas de etiquetado, verificación, transcripción, evaluación de respuestas y moderación que sostiene a sistemas presentados como automáticos. Lo más incisivo de su tesis es que esa invisibilidad es parte del producto, porque la ilusión de automaticidad es buena parte de lo que se vende.
Esto nos remite a la fascinación que despertaba uno de los autómatas más famosos de la historia, El Turco ajedrecista, que dependía de que no se supiera del humano agazapado dentro del gabinete.
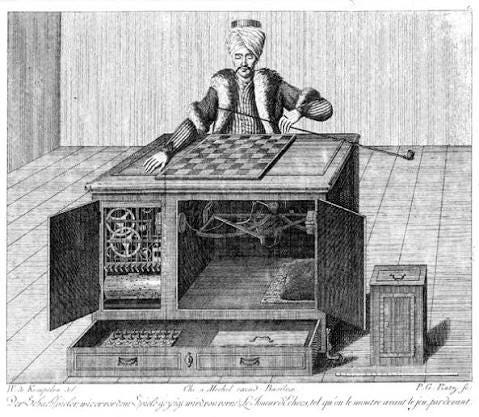
Lo construyó Wolfgang von Kempelen en 1769 y lo presentó al año siguiente en la corte de María Teresa de Austria. Era un mueble de madera con un maniquí de turbante que movía las piezas, y adentro viajaba un ajedrecista de carne y hueso que seguía la partida en un tablero auxiliar y accionaba el brazo mediante un sistema de palancas. Le ganó a Benjamin Franklin. Le ganó a Napoleón en Schönbrunn, en 1809. Charles Babbage jugó contra él en 1820 y salió convencido de que había truco, igual que Edgar Allan Poe, que en 1836 publicó un ensayo razonando por qué adentro tenía que haber un hombre.
A lo largo de su vida lo operaron al menos quince maestros distintos. Ninguno figuraba con su nombre en el programa del espectáculo.
Y acá viene lo que me parece asombroso, porque no es una analogía que yo esté forzando desde afuera. Cuando Amazon lanzó en 2005 su plataforma de microtareas humanas, la llamó Amazon Mechanical Turk, por el autómata. Jeff Bezos acuñó para describirla la expresión artificial artificial intelligence, inteligencia artificial artificial —utilizar humanos conectados en red para realizar a bajo costo tareas cognitivas sencillas que el software aún no podía resolver por sí mismo, simulando un procesamiento algorítmico automatizado a través de una API—. La empresa nombró el truco, lo explicó en público y siguió vendiéndolo igual.
Hay un dato con fecha de este mes. Esa plataforma, que en 2011 declaraba más de quinientos mil trabajadores registrados en ciento noventa países, cierra definitivamente el 30 de septiembre, según anunció Amazon el 25 de agosto. Los análisis del sector atribuyen la salida a la migración de los trabajadores hacia competidores como Scale AI o Mercor.
El trabajo fantasma no desapareció. Cambió de galpón.
Antonio Casilli (2021) mostró que ese trabajo se organiza en cadenas internacionales de subcontratación cuya geografía reproduce, con bastante fidelidad, la vieja división internacional del trabajo. Las tareas de mayor valor se concentran en los centros. La anotación y la moderación se desplazan hacia donde el salario es bajo.
El español y el portugués son dos de los idiomas que estos sistemas necesitan anotar. Adiviná dónde se consigue gente que los hable bien y cobre poco…
Acá vuelve el argumento que vengo siguiendo. David Graeber (2015) describió cómo, en los años setenta, la deslocalización industrial produjo desde Europa, los Estados Unidos y Japón la impresión de que había llegado la sociedad postindustrial. Las fábricas no habían desaparecido. Se habían mudado, y la producción material seguía haciéndose con formas relativamente convencionales de trabajo industrial, en otra parte del planeta.
Hoy, la automatización simbólica repite el movimiento un nivel más abajo.
Desde la interfaz, la operación parece puramente lingüística. Uno escribe una pregunta y aparece un texto. Materialmente, esa operación descansa sobre galpones refrigerados, redes eléctricas, minería, agua y trabajo humano barato ejecutado lejos de donde se consume el resultado.
La ilusión postindustrial tuvo una segunda edición, y esta vez la fábrica invisible no queda en Shenzhen. Queda en Canelones, en Cerrillos, en Querétaro.
La discusión latinoamericana sobre inteligencia artificial se plantea casi siempre en términos de adopción y de regulación. Si la usamos o no, si la enseñamos o no, cómo la regulamos. Como si nuestra posición en el asunto fuera la del usuario. Y no lo es, o no solamente.
La región participa de esta infraestructura en tres registros simultáneos. Como proveedora de los minerales que el cómputo demanda, con el litio del triángulo andino y el cobre chileno y peruano a la cabeza. Como territorio en disputa para instalar centros de datos que buscan energía barata, agua disponible y marcos regulatorios permisivos. Y como reservorio de trabajo lingüístico calificado y mal pago para anotar y moderar en español y en portugués. Tres formas de estar adentro, y ninguna se parece a la de un usuario.
Como ya saben, no escribo esto para proponer que apaguemos nada. Estoy muy lejos de eso.
Lo escribo porque los términos son negociables, y porque tenemos evidencia de que lo son. El caso uruguayo lo muestra con bastante claridad. La discusión pública no frenó la instalación del centro de datos, y sí cambió su diseño. Un sistema de refrigeración por aire en lugar de uno que iba a tomar millones de litros de agua en medio de una sequía histórica.
Eso no se decidió en un debate sobre si la inteligencia artificial piensa. Se decidió en audiencia pública, discutiendo un expediente, un permiso y un acuífero.
Y ahí hay una lección que interpela a quienes escribimos sobre estos temas, yo incluido. Las preguntas más interesantes —qué es un sujeto, qué entiende una máquina, qué queda del autor— no son las que más deciden. Se decide en trámites que casi nadie mira.
Por eso hoy insisto tanto con la nube, esa noción, la que más les cuesta a mis estudiantes. La que, a pesar de su poético nombre, es la única que tiene dirección postal y, por lo tanto, puede ser influida por demandas ciudadanas situadas. Pero para eso debemos, en primer lugar, interesarnos e informarnos bien.
Referencias
Gray, M. L., & Suri, S. (2019). Ghost work: How to stop Silicon Valley from building a new global underclass. Houghton Mifflin Harcourt.
Casilli, A. A. (2021). Esperando a los robots: Encuesta sobre el trabajo del clic (C. Piña, Trad.). Fondo de Cultura Económica.
Graeber, D. (2015). The utopia of rules: On technology, stupidity, and the secret joys of bureaucracy. Melville House.
Hay truco encerrado en las metáforas tecnológicas y su forma de hacerse presente a nuestra experiencia de turcos en la neblina. Despejar la niebla de palabras es clave para actuar políticamente, de un modo reaccionario o patético. Sino con conocimiento de lo que está en juego y las posibilidades de vislumbrar alternativas identificando las relaciones de fuerza que pueden incidir en el descelance de la partida de ajedrez